
免费小说在线阅读的代价:找书的版权风险与稳定性
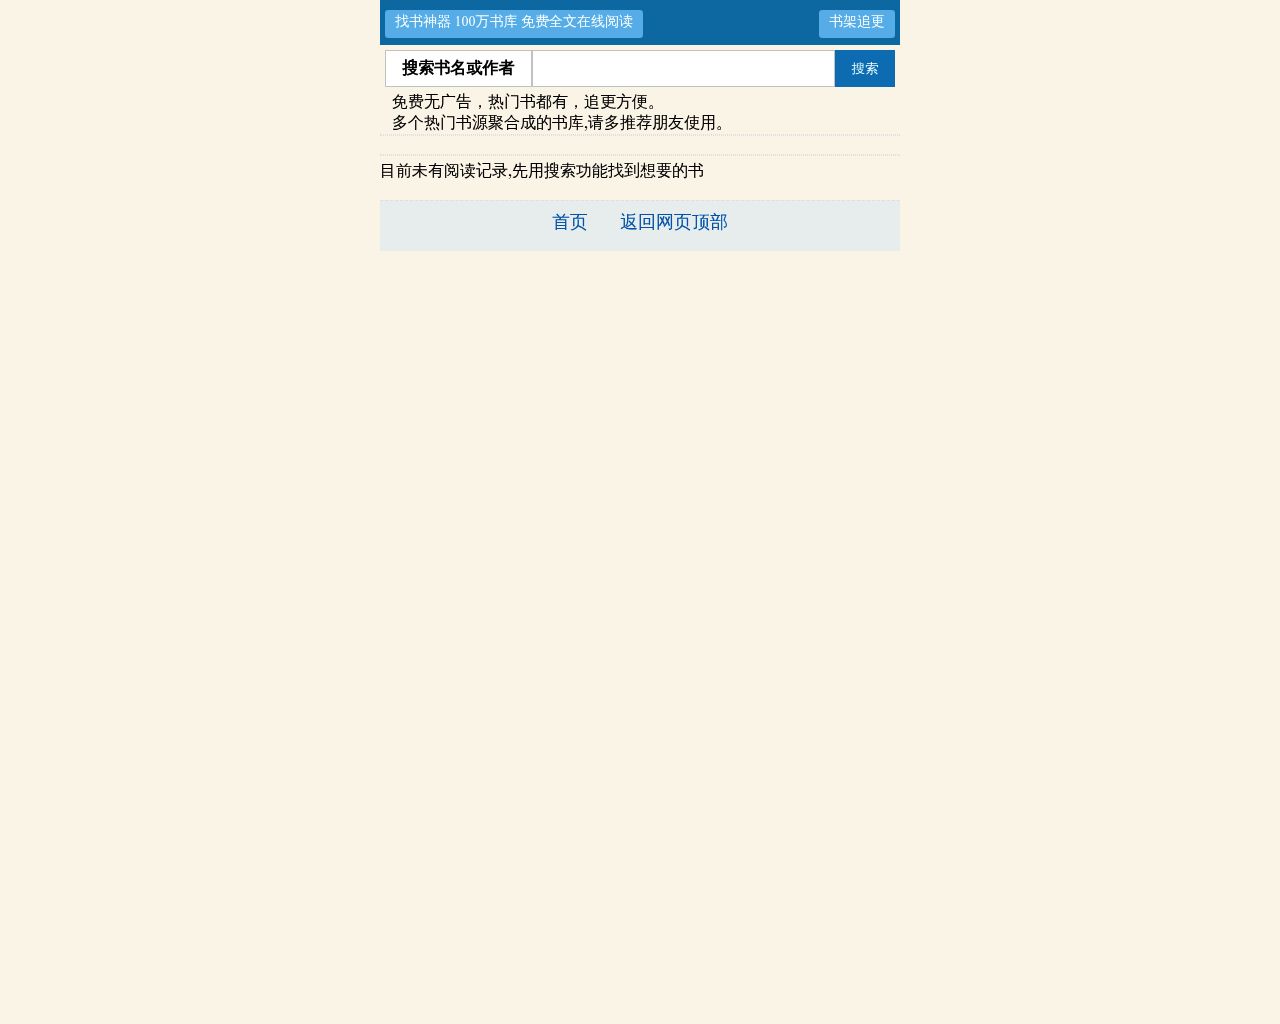
找书官网首页用「100 万书库」「永久免费无广告」「免注册」几个词介绍自己,同时注明书库由「多个热门书源聚合而成」。但官网没有公开任何一个书源的来源或授权信息。对想免费看小说的读者来说,这意味着无法验证自己正在读的内容是否经过授权。
稳定性是第二个没有兜底的问题。找书不生产内容,只聚合外部书源。上游书源一旦停更、失效或被移除,对应的搜索结果和追更就会中断。阅读页里的「催促检查更新」按钮,本身就是官方为书源滞后准备的补救入口。修不修得好,取决于上游站点,不取决于找书。
再看商业模式。免费、无广告、不要求注册,服务器和带宽成本靠什么维持?官网没有公开运营方信息,也没有公开任何收入来源。版权合规无法验证,运营可持续性不明,这两点是尝试前必须了解的核心风险。
重新认识找书:一个怎么样的小说聚合平台
找书的定位是聚合平台,不是内容提供者。这个平台本身不生产小说,只提供搜索和在线阅读入口。目标用户是寻求免费小说阅读的读者,尤其是习惯用手机浏览器直接看书的群体。
名字里的营销成分
「找书」这个名字自带营销味,暗示一种无所不能的找书能力。有用户因此称它「神级」找书工具,理由集中在免费、无广告、书源丰富这三点。但「神级」评价与版权隐患并存,恰恰是这类平台最典型的矛盾。实际功能边界从未被官方明确定义。
书库规模的口径
「100 万本」这个数字来自官网首页自述,未经第三方核验。书源是否持续更新、有没有重复或失效内容,官网未公开。从官网页面看,这个平台提供的功能就是三件事:搜索书名或作者、在线阅读、加入书架追更。没有排行榜,没有书评社区,没有下载选项。
从搜索到追更:找书的功能全链路
| 功能 | 实际情况 |
|---|---|
| 搜索 | 官网只提供一个「搜索书名或作者」输入框,没有公开匹配机制和排序逻辑,实际效果取决于聚合书源的元数据质量 |
| 书架追更 | 加入书架后自动追更最新章节,这是官网的原话;但追更依赖书源的更新频率,书源停更或失效,追更就中断,阅读页为此提供了「催促检查更新」按钮 |
| 免费无广告 | 官网承诺「永久免费无广告」,页面未见广告位,这是用户反馈中最受好评的一点 |
| 免注册阅读 | 打开网站即可搜索和阅读,无需账户,代价是书架和进度只存在浏览器本地 |
| 功能口径分歧 | 部分第三方软件库的介绍提到离线阅读、书签管理、听书;官网页面实际提供的是字体大小调节(大/中/小)和关灯、护眼模式,没有离线下载和书签入口。功能以官网实际展示为准 |
从打开到上手:找书的最短路径
这条最短路径,是按官网页面逐项核对后整理的:
- 打开找书官网,页面直接显示搜索框,无需注册或登录。
- 输入书名或作者并搜索,结果以列表呈现,标注各数据源的最新更新章节。
- 点击任一结果进入阅读页,正文直接加载,顶部有「加入书架追更」按钮。
- 加入书架后,同一浏览器再次打开网站,书架内容仍在。
- 清理浏览器缓存、更换设备或使用无痕模式,书架数据全部消失。
这个流程的核心代价在第 5 步。免注册意味着没有云端账户体系,阅读进度、书架列表、最近阅读记录全部依赖浏览器本地存储。用户反馈里有人称赞手机端网页「丝滑」,但几乎没人提数据持久性。大多数人还没遇到缓存被清的情况。
找书的局限性:哪些场景下不够用
| 限制项 | 具体表现 |
|---|---|
| 无排行榜 | 没有热门榜、新书榜或分类榜,只能主动搜索,无法发现新作品 |
| 不支持下载 | 所有内容只能在线阅读,网络不稳定或需要离线的场景下不可用 |
| 仅简体中文 | 界面和内容均为简体中文,繁体或其他语言读者没有原生体验 |
| 无账户体系 | 书架、进度无法跨设备同步,换机、清缓存都会丢数据 |
| 书源不透明 | 不知道内容来自哪个书源,也无法判断授权状态 |
| 追更不可靠 | 书源更新延迟或停止时,追更形同虚设,而且不会有通知 |
这些限制对进阶读者影响更大。需要离线阅读、跨设备同步进度、主动发现新书的人,在这个平台上都得不到满足。
使用找书容易踩的误区
- 误区一:默认书源合法。官网未公开授权信息,聚合书源往往来自第三方抓取,版权状态不明。建议:无法确认内容来自公版或明确授权书源时,谨慎使用。
- 误区二:以为书架云端同步。免注册就没有云端备份。建议:重要进度手动记录,或者接受丢失风险。
- 误区三:指望追更永远可靠。书源失效后追更立即中断,且不会有通知。建议:连载作品不要只依赖一个追更入口。
- 误区四:默认免费可持续。官网未公开盈利模式,随时可能关停或转向收费。建议:不要把找书当作唯一阅读渠道。
- 误区五:把搜索排序当质量排序。排序逻辑未公开,排在前面的不一定是质量最高、更新较快的书源。建议:多试几个搜索结果,对比章节完整度和更新日期。